Скачать WebData Extractor – веб‑скрейпинг, извлечение данных, инструмент для онлайн‑исследований
Обзор
WebData Extractor — специализированная утилита, разработанная для упрощения процесса сбора информации с веб‑сайтов. Ее основная цель — позволить пользователям извлекать различные типы цифрового контента — такие как текст, изображения, ссылки и HTML — непосредственно со страниц с минимальными усилиями. Приложение особенно полезно для людей, занимающихся онлайн‑исследованиями, агрегацией контента или сбором данных для личных или профессиональных проектов. Организуя извлеченные данные в четко помеченных вкладках, оно повышает доступность и сокращает время, необходимое для поиска конкретных типов контента.
Инструмент решает типичные проблемы, связанные с ручным сбором данных, такие как неэффективность, непоследовательность и высокая когнитивная нагрузка. Он предоставляет структурированную среду, где пользователи могут управлять разнообразными форматами данных в одном месте, делая его ценным активом в цифровых рабочих процессах. Хотя разработчик не предоставил дополнительной информации, долговечность приложения — первое выпуск в 2012 году — свидетельствует о стабильной и надежной основе. Такое длительное присутствие в экосистеме программного обеспечения подчеркивает его актуальность для пользователей, ищущих последовательную, без излишеств функцию извлечения данных.
Практические примеры использования включают академические исследования, конкурентный анализ, кураторство контента и цифровой архив. Приложение поддерживает пользователей, которым необходимо одновременно захватывать визуальный и текстовый контент, например, для маркетинговых презентаций или справочных материалов по веб‑дизайну. Несмотря на то, что это в первую очередь настольный инструмент, его принципы эффективности и низкого потребления ресурсов хорошо применимы к мобильным рабочим процессам, особенно при учете синхронизации данных между устройствами. Разработчик не указал совместимость с мобильными платформами, поэтому текущая доступность для мобильных устройств остается неясной.
Ключевые функции и возможности
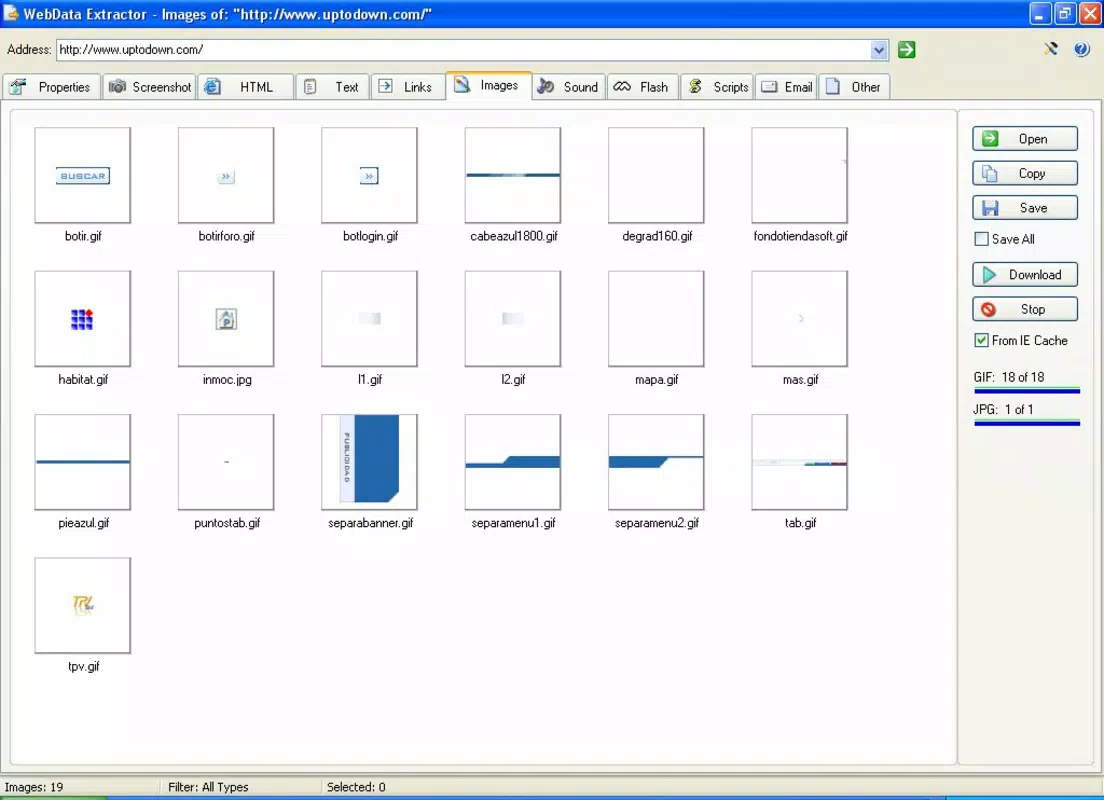
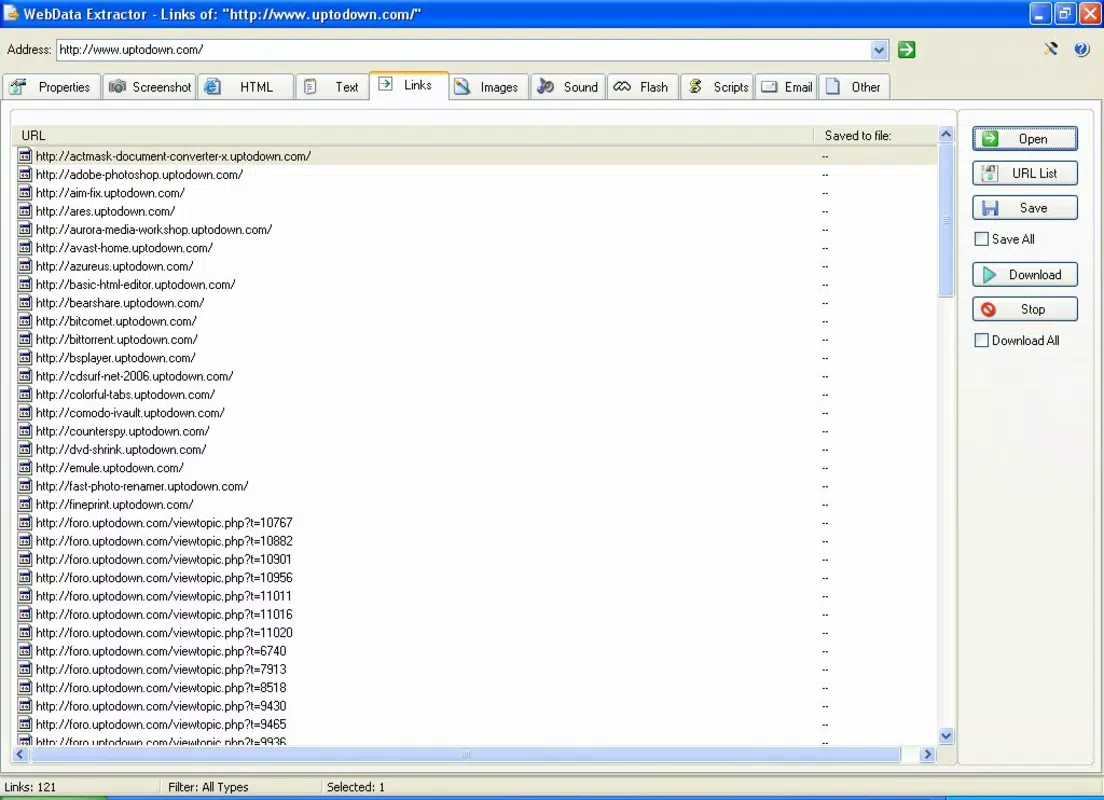
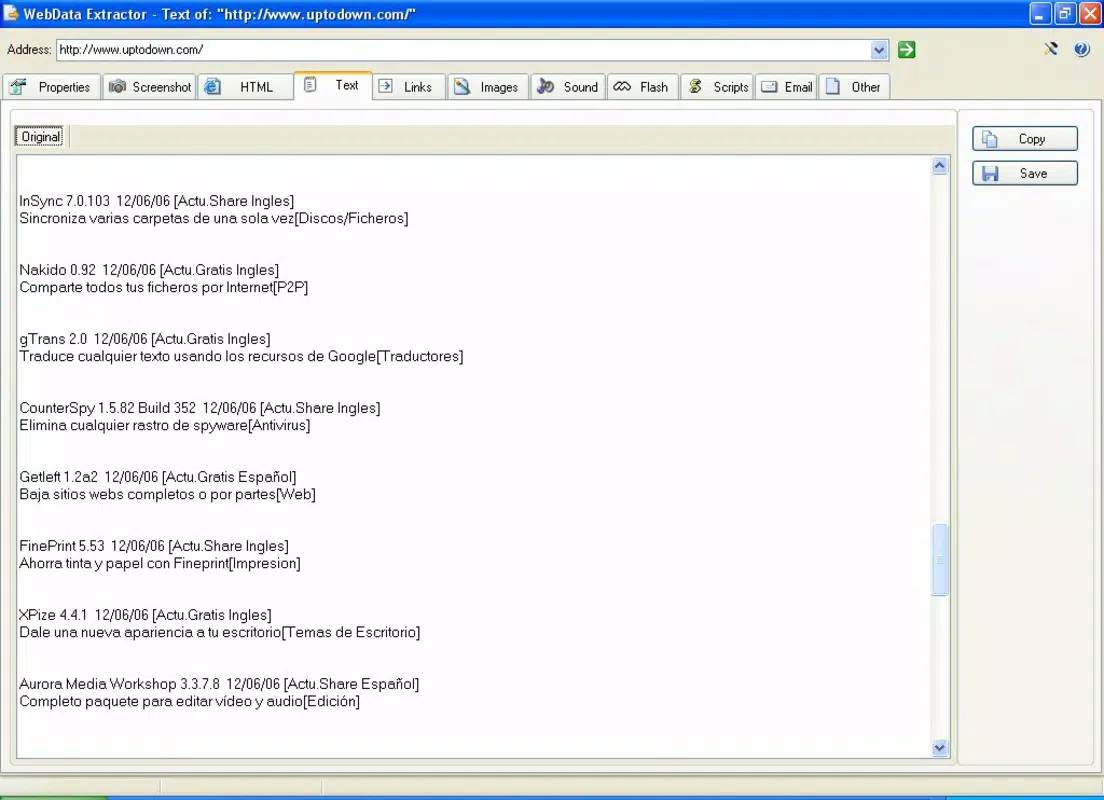
- Удобный интерфейс: Приложение имеет чистый, основанный на вкладках макет, который классифицирует извлеченные данные по отдельным разделам — изображения, текст, ссылки и другой контент. Такой дизайн позволяет пользователям без усилий переключаться между типами данных, улучшая навигацию и уменьшая беспорядок. Интерфейс доступен как для начинающих, так и для продвинутых пользователей, минимизируя кривую обучения.
- Полное извлечение данных: WebData Extractor поддерживает получение множества типов контента с веб‑сайтов, включая полный HTML‑исходник, встроенные медиафайлы и гиперссылки. Эта широкая возможность гарантирует, что пользователи могут собрать полную «снимок» содержимого веб‑страницы, что важно для тщательных исследований или документации.
- Эффективная работа с ресурсами: Разработан для работы в фоновом режиме с минимальным влиянием на производительность системы, инструмент остается активным, не потребляя значительные ресурсы ЦП или памяти. Его можно свернуть в панель задач, позволяя пользователям продолжать работу над другими задачами, пока идет сбор данных.
- Горячие клавиши: Приложение включает настраиваемые комбинации клавиш, ускоряющие выполнение часто используемых действий. Эти сочетания повышают эффективность рабочего процесса, особенно для пользователей, часто выполняющих извлечения и предпочитающих быстрый доступ к функциям.
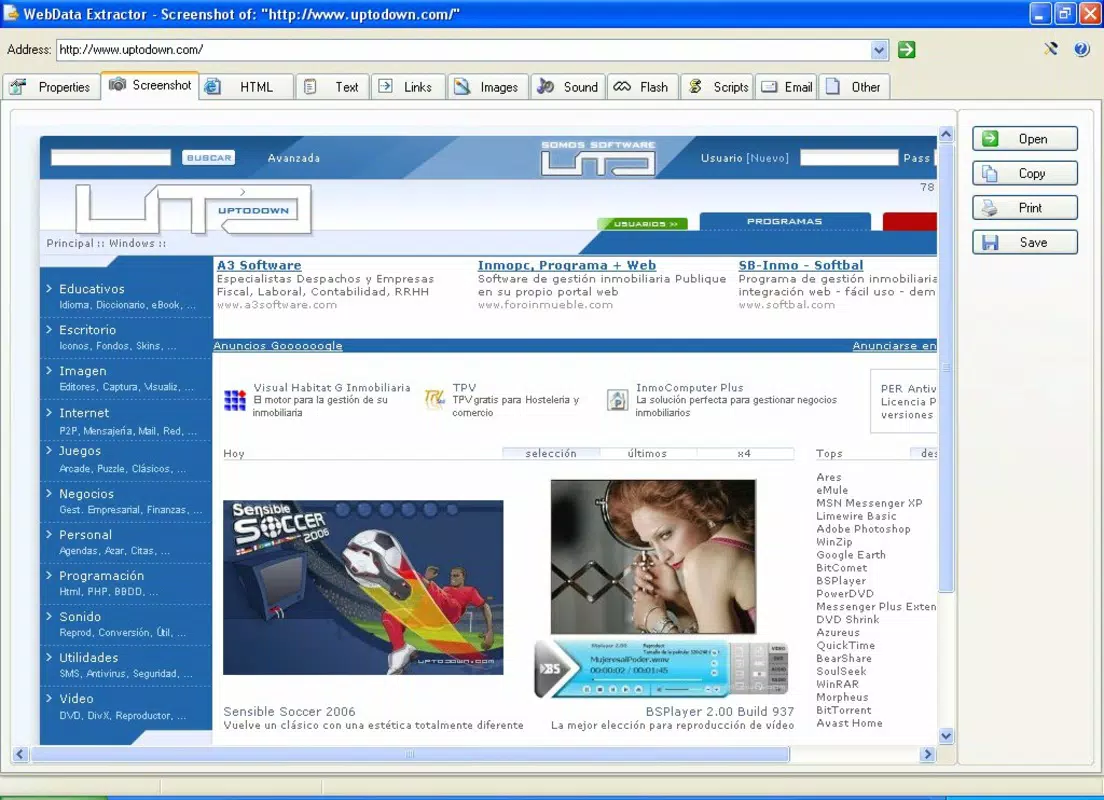
- Функция захвата экрана: Одна из выдающихся возможностей приложения — возможность делать полностраничные скриншоты веб‑сайтов непосредственно через интерфейс. Эта функция дополняет извлечение текста и ссылок, сохраняя визуальный контекст, что критично для проектов, требующих как текстовых, так и графических данных.
Например, студент, собирающий источники для диссертации, может использовать инструмент для извлечения ключевых отрывков, сохранения релевантных изображений и создания скриншотов справочных страниц — всё в одной сессии. Аналогично, маркетолог может собрать контент конкурентов, включая описания продуктов и визуальные материалы, для анализа тенденций. Интеграция визуального и текстового сбора данных повышает глубину и точность конечного результата.
Интерфейс, UX и производительность
Пользовательский интерфейс WebData Extractor разработан с упором на ясность и функциональность. Он использует табуляцию навигации, разделяющую типы данных, позволяя пользователям без путаницы переключаться между изображениями, текстом, ссылками и другим контентом. Визуальный макет минималистичен, сосредоточен на удобстве использования, а не на декоративных элементах, что способствует отсутствию отвлекающих факторов.
Навигация интуитивна, с постоянным расположением элементов управления и четкой маркировкой. Пользователи могут запустить извлечение одним щелчком, а результаты отображаются сразу в соответствующей вкладке. Отзывчивость приложения заметна, с минимальными задержками при получении и обработке данных. Хотя разработчик не указал формальные метрики производительности, способность работать в фоновом режиме свидетельствует о оптимизированном коде и эффективном управлении памятью.
Производительность на разных типах устройств явно не документирована. Тем не менее, низкое потребление ресурсов подразумевает, что приложение должно работать плавно на широком спектре систем, включая те, что имеют ограниченные вычислительные мощности. Стабильность выглядит как сильная сторона, учитывая длительное присутствие с 2012 года. Сообщений о сбоях или зависаниях не поступало, интерфейс остается последовательным в разных сеансах.
Совместимость платформ и технические требования
WebData Extractor доступен для настольных платформ, хотя конкретная операционная система не указана. Размер файла приложения не раскрыт, и минимальные требования к ОС не определены. Известны номер версии и дата выпуска: последняя версия вышла 30 марта 2012 года.
Разработчик не предоставил дополнительных технических деталей, таких как совместимость с современными операционными системами или аппаратными характеристиками. Поэтому пользователям следует проявлять осторожность при установке на новых системах, так как могут возникнуть потенциальные проблемы совместимости. Отсутствие обновленной информации о релизах подразумевает, что приложение может не получать регулярных обновлений или поддержки для текущих платформ.
Плюсы и минусы
- Интуитивный интерфейс на основе вкладок для упорядоченного доступа к данным
- Поддержка извлечения множества типов контента, включая изображения и HTML
- Эффективная работа в фоновом режиме с минимальным воздействием на систему
- Включены горячие клавиши для ускорения рабочего процесса
- Встроенная функция захвата экрана для сбора визуальных данных
- Дата выпуска указывает, что приложению более десяти лет; могут отсутствовать современные функции
- Совместимость с текущими операционными системами не подтверждена
- Отсутствие официальных обновлений или информации о поддержке
- Размер файла и системные требования не раскрыты
- Недоступно для мобильных платформ согласно текущей информации
FAQ
Доступен ли WebData Extractor для Android или iOS?
Разработчик не указал наличие мобильных версий. Приложение, по всей видимости, предназначено для настольного использования, и официальных версий для Android или iOS не упоминалось.
Можно ли использовать WebData Extractor для извлечения данных с любого веб‑сайта?
Да, приложение разработано для извлечения данных с различных веб‑сайтов. Однако фактический успех может зависеть от структуры сайта, мер безопасности и условий обслуживания.
Требуется ли WebData Extractor подключение к интернету?
Да, активное подключение к интернету необходимо для доступа к веб‑сайтам и извлечения их контента.
Безопасно ли скачивать и устанавливать это приложение?
Хотя приложение используется с 2012 года, пользователям следует загружать его из проверенного источника. Разработчик не предоставил официальных каналов распространения.
Есть ли регулярные обновления для WebData Extractor?
Нет признаков недавних обновлений. Последний известный релиз был в 2012 году, информация о будущих обновлениях не предоставлена.
Заключительные мысли
WebData Extractor остаётся функциональным инструментом для пользователей, ищущих простой способ извлечения и организации веб‑контента. Его чистый интерфейс, многоформатное извлечение и работа в фоновом режиме делают его практичным выбором для исследователей, маркетологов и создателей контента, ценящих эффективность и простоту. Несмотря на возраст, вызывающий вопросы совместимости и современных функций, основная функциональность продолжает эффективно обслуживать нишевые потребности.
Для тех, кто отдает предпочтение лёгкому, без излишеств сбору данных без сложности продвинутых инструментов, WebData Extractor предлагает надёжное, хотя и устаревшее, решение. Однако пользователям следует тщательно оценить совместимость с текущими системами перед установкой. Учитывая отсутствие недавних обновлений, он лучше всего подходит для устаревших сред или специфических сценариев, где современные альтернативы не требуются.
Скачать WebData Extractor сейчас


